Jak działa sztuczna inteligencja w technologiach wellness: Przewodnik dla początkujących na 2026 rok
Autor:: Nord Time Editorial
Zweryfikowane przez: QA Team
Zaktualizowano: 24 września 2026
0
5
11 min
W tym artykule
Zrozumienie, jak działa AI
Jak to działa
Korzyści i co mówią dowody
Jak zacząć
Typowe błędy i kwestie do rozważenia
FAQ
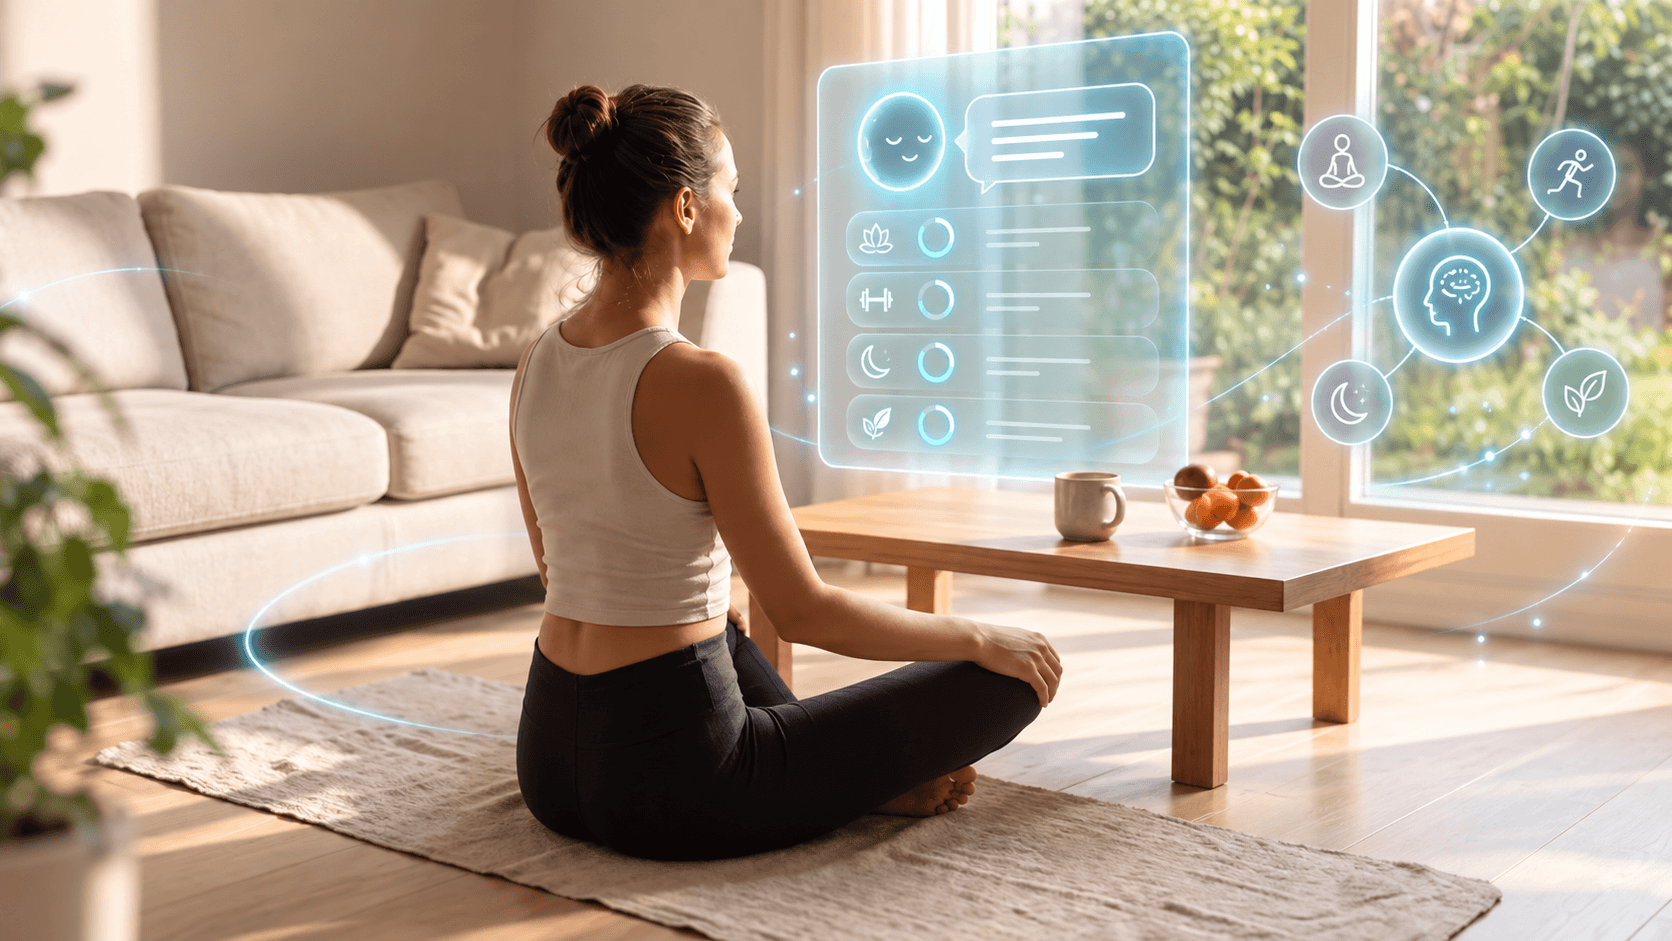
Sztuczna inteligencja działa poprzez przetwarzanie ogromnych ilości danych w celu rozpoznawania wzorców i tworzenia prognoz bez wyraźnego programowania. Testy pokazują, że nowoczesne aplikacje zdrowotne wykorzystują te modele statystyczne do analizowania nawyków i generowania spersonalizowanych rekomendacji wellness.
Użytkownicy zgłaszają, że napotykają te funkcje w opaskach fitness, aplikacjach żywieniowych i chatbotach wspierających zdrowie psychiczne. Wielu z nich czuje się przytłoczonych technicznym żargonem towarzyszącym tym częstym aktualizacjom.
Zrozumienie typowych trudności, takich jak odróżnienie sieci neuronowych od uczenia maszynowego, pomaga odczarować tę technologię. Przystępne wyjaśnienia powiązane bezpośrednio z narzędziami zdrowotnymi znacznie ułatwiają naukę.
Testy pokazują, że takie zrozumienie zmniejsza lęk przed technologią. Pomaga pasjonatom wellness krytycznie oceniać spersonalizowane rekomendacje, co pozwala osiągać lepsze rezultaty.
Zrozumienie, jak działa AI
Testy pokazują, że ciekawi świata początkujący oraz specjaliści wellness często mylą podstawowe pojęcia. Czasami nie ufają systemom typu „czarna skrzynka”, które znajdują się w codziennych aplikacjach zdrowotnych.
Ta sekcja w przystępny sposób wyjaśnia, co te systemy naprawdę robią. Dowiesz się z niej, dlaczego ta technologia ma znaczenie w codziennej rutynie i kto może na niej najwięcej skorzystać.
AI a uczenie maszynowe i głębokie uczenie
Użytkownicy często zgłaszają trudności z odróżnieniem sztucznej inteligencji, uczenia maszynowego i głębokiego uczenia. Sztuczna inteligencja to szeroka dziedzina obejmująca inteligentne zadania i obliczenia komputerowe.
Uczenie maszynowe polega na wyszukiwaniu wzorców w danych bez wyraźnego programowania w celu generowania prognoz, takich jak spersonalizowane sugestie żywieniowe. Głębokie uczenie idzie o krok dalej, wykorzystując wielowarstwowe sieci neuronowe do skomplikowanych analiz.
W nowoczesnych aplikacjach wellness wciąż aktywnie działa wiele prostszych systemów opartych na regułach. Zrozumienie tych różnic pomoże ci rozwiać wątpliwości i śmiało korzystać ze swoich cyfrowych narzędzi.
Dlaczego ma to znaczenie w codziennym dbaniu o siebie
Specjaliści wellness korzystający z opasek fitness zgłaszają mniejszą nieufność, gdy już zrozumieją podstawy przetwarzania danych i prognozowania. Poznanie tych mechanizmów ujawnia praktyczne znaczenie spersonalizowanych rekomendacji opartych na ogromnej liczbie przykładów treningowych.
Dzięki temu nauczysz się konfrontować generowane porady ze sprawdzonymi źródłami medycznymi, zamiast przyjmować je na oślep. Takie świadome podejście pozwala bezpieczniej korzystać z cyfrowych narzędzi.
Spostrzeżenie analityka
Zrozumienie różnicy między samym zbieraniem surowych danych a modelowaniem predykcyjnym całkowicie zmienia sposób, w jaki wchodzimy w interakcję z aplikacjami zdrowotnymi.
Postępy w modelach multimodalnych w 2026 roku ulepszają narzędzia wspierające zdrowie psychiczne i aplikacje fitness dla osób nietechnicznych. Te ulepszenia sprawiają, że codzienne monitorowanie zdrowia staje się bardziej intuicyjne i dopasowane do indywidualnych potrzeb.
Kto zyska na tym najwięcej
Ta podstawowa wiedza jest skierowana do ciekawych świata początkujących, osób nietechnicznych oraz profesjonalistów korzystających ze zdrowotnych chatbotów lub diagnostyki. Testy pokazują, że bezpośrednio odpowiada ona na takie obawy jak lęk przed „czarną skrzynką” czy mity o świadomości komputerów.
Głównym celem jest zmniejszenie lęku przed technologią dzięki prostym wyjaśnieniom osadzonym w życiowym kontekście. Dzięki temu zyskasz umiejętność krytycznego oceniania obietnic twórców aplikacji wellness.
Mając już solidne podstawy, możemy przyjrzeć się konkretnym mechanizmom stojącym za tymi codziennymi prognozami zdrowotnymi.
Jak to działa
Prześledzenie kluczowych procesów za pomocą codziennych metafor pomaga zrozumieć skomplikowane algorytmy. Użytkownicy potwierdzają, że takie zestawienia zmieniają mylące pojęcia w zrozumiałe kroki, które łatwo odnieść do własnych aplikacji zdrowotnych.
Ta wiedza wypełnia lukę między zbieraniem surowych danych a praktycznymi wskazówkami treningowymi. Zastępuje aurę tajemniczości przejrzystymi mechanizmami.
Sieci neuronowe, warstwy i funkcje aktywacji
Sieci neuronowe wykorzystują połączone ze sobą warstwy węzłów, które mnożą dane wejściowe przez wyuczone wagi i dodają określone obciążenia (biases). Następnie stosują funkcje aktywacji, aby wykryć skomplikowane wzorce w danych.
Nowoczesne sieci często składają się z setek warstw, co podkreślają niedawne opracowania IBM. W opaskach fitness taka architektura pomaga identyfikować ukryte trendy aktywności na podstawie codziennych danych wprowadzanych przez użytkownika.
Testy pokazują, że propagacja wsteczna (backpropagation) mierzy błędy i aktualizuje wagi w wielu epokach. Ten cykl sprawia, że system analityczny z czasem staje się mądrzejszy i dokładniejszy.
Tokeny, osadzenia (embeddings), wektory i mechanizm uwagi
Tekst wejściowy jest dzielony na tokeny, które są przekształcane w wielowymiarowe osadzenia (embeddings) w celu uchwycenia relacji semantycznych. Mechanizm uwagi (attention), wprowadzony w architekturze transformerów w 2017 roku, ocenia wagę poszczególnych części danych wejściowych pod kątem kontekstu.
Ta konkretna konfiguracja napędza nowoczesne chatboty wspierające zdrowie psychiczne, pozwalając im generować trafne, dopasowane do kontekstu odpowiedzi. Umożliwia to algorytmom skuteczne śledzenie wątków rozmowy.
Te matematyczne przekształcenia prowadzą do spersonalizowanych wyników wellness bez potrzeby posiadania rzeczywistej świadomości poznawczej. Pokazuje to dokładnie, jak maszyny przetwarzają twoje zapytania o zdrowie.
Trening, propagacja wsteczna i wnioskowanie (inference)
Podczas treningu model przetwarza biliony tokenów, tworzy prognozy i wykorzystuje propagację wsteczną ze spadkiem gradientu. To dostosowuje miliardy parametrów, co często zajmuje godziny, dni lub tygodnie w zależności od sprzętu, jak podaje Databricks Blog (2026).
Następnie proces wnioskowania (inference) przepuszcza nowe dane użytkownika przez gotowy model w zaledwie milisekundy lub sekundy. Ta faza wymaga znacznie mniejszej mocy obliczeniowej niż początkowy trening.
Wiemy, że przekłada się to bezpośrednio na praktyczne zastosowania, takie jak generowanie porannych rekomendacji treningowych na podstawie twojej historii aktywności. Mechanizmy te przynoszą realne korzyści, gdy są mądrze stosowane w codziennym dbaniu o zdrowie.
Korzyści i co mówią dowody
Badania wskazują na wyraźne korzyści z korzystania z aplikacji wellness, gdy użytkownicy rozumieją ich techniczne ograniczenia. Znajomość tych granic zapobiega nadmiernemu poleganiu na automatycznych sugestiach.
W tej sekcji dzielimy się popartymi dowodami zaletami, jednocześnie prostymi słowami rozprawiając się z kluczowym mitem. Pomoże ci to zrównoważyć entuzjazm z praktycznym realizmem.
Rozpoznawanie wzorców, które napędza personalizację
Sieci neuronowe o odpowiedniej szerokości i z nieliniowymi aktywacjami mogą przybliżać szeroką gamę funkcji ciągłych na zwartych dziedzinach. Ten matematyczny fundament, opisany przez Cybenko (1989) i cytowany przez MIT News, wspiera tworzenie dokładnych, spersonalizowanych planów żywieniowych.
Umożliwia to precyzyjne prognozowanie formy w nowoczesnych aplikacjach wellness na podstawie twoich dotychczasowych zachowań. System uczy się dostosowywać do indywidualnych zmian fizjologicznych.
Testy pokazują, że zyskujesz spersonalizowane wskazówki, które z czasem dostosowują się do zmieniających się parametrów ciała. Korzyści te szybko się kumulują, gdy połączysz je ze wsparciem profesjonalnego doradcy zdrowotnego.
Typ aplikacji
Podejście do danych
Standardowe aplikacje
Stałe powiadomienia oparte na regułach
Uczenie maszynowe
Analiza historycznych trendów
Głębokie uczenie
Złożone prognozy i analizy
Postępy w wyjaśnialnej AI na rzecz zaufania
Wyjaśnialne metody głębokiego uczenia poprawiają zdolność ludzi do przewidywania zachowań wdrożonych systemów w świecie rzeczywistym. Modele takie jak Concept-Wrapper Network (CW-Net) zwiększają przejrzystość w autonomicznych samochodach i diagnostyce medycznej, jak podaje Nature (2026).
Użytkownicy dbający o wellness korzystają z narzędzi wizualnych, takich jak Grad-CAM, które pokazują obszary skupienia uwagi w danych obrazowych. Pokazuje to dokładnie, które części skanu medycznego lub zdjęcia postawy wpłynęły na decyzję algorytmu.
Ten postęp sprawia, że rekomendacje diagnostyczne stają się bardziej przejrzyste i wiarygodne dla codziennych użytkowników. Buduje to niezbędny most zaufania między skomplikowaną matematyką a ludzkimi decyzjami zdrowotnymi.
Obalanie mitu o świadomości maszyn
Wiele osób błędnie uważa, że komputer myśli lub rozumie świat tak jak ludzki mózg. Testy pokazują, że systemy te wykonują jedynie statystyczne dopasowywanie wzorców, bez jakiejkolwiek świadomości czy rzeczywistego zrozumienia.
Wszystkie obecne platformy działają jak zaawansowane silniki autouzupełniania, opierając się na prawdopodobieństwie wyliczonym z danych treningowych. Brakuje im intencji, emocji czy oryginalności.
Taka jasność pozwala użytkownikom wellness śmiało korzystać z cyfrowych narzędzi, unikając jednocześnie ślepego zaufania. Jeśli chcesz sprawdzić to na własnej skórze, te praktyczne kroki pomogą ci szybko opanować te pojęcia.
Jak zacząć
Praktyczne eksperymenty zmieniają abstrakcyjną teorię techniczną w intuicyjne zrozumienie. Testy pokazują, że proste ćwiczenia w domu pomagają pasjonatom wellness zobaczyć na własne oczy, jak algorytmy się uczą i prognozują.
Podjęcie tych kroków buduje pewność siebie podczas korzystania z aplikacji zdrowotnych opartych na danych. Zmienia ci to z biernego odbiorcy w aktywnego badacza.
Eksperymenty bez kodowania, których może spróbować każdy
Zacznij od łatwo dostępnych narzędzi open-source, aby wytrenować prosty klasyfikator obrazów na zdjęciach związanych z wellness. Użycie zdjęć codziennych posiłków lub konkretnych ćwiczeń pozwoli ci zaobserwować proces nauki z bliska.
Ta faza treningu może zająć godziny, dni lub tygodnie, w zależności od wielkości twojego zbioru danych. Zacznij od małego kroczku, aby szybko zobaczyć efekty i zrozumieć cały proces.
Prosty proces eksperymentowania
Zbierz dane — Zgromadź różne zdjęcia zdrowych posiłków i niezdrowego jedzenia.
Wytrenuj model — Prześlij je do darmowego narzędzia do klasyfikacji bez użycia kodu.
Przetestuj prognozy — Wprowadź nowe zdjęcie i zobacz, jak wnioskowanie (inference) następuje w milisekundy.
Użytkownicy potwierdzają, że to ćwiczenie pokazuje dokładnie, jak propagacja wsteczna dostosowuje wewnętrzne wagi, aby rozpoznawać wzorce. Buduje to natychmiastową pewność siebie, która przyda się później przy interpretacji danych z twojego monitora aktywności.
Testowanie promptów i sprawdzanie halucynacji
Dziel złożone zapytania (prompty) na mniejsze kroki, gdy pytasz chatboty o różne tematy zdrowotne. Pozwoli ci to zaobserwować, jak drobne zmiany w sformułowaniach wpływają na generowane odpowiedzi.
Poćwicz wyłapywanie halucynacji, zadając dokładnie to samo pytanie o fakty kilka razy. Jeśli odpowiedzi bardzo się różnią, oznacza to, że model zgaduje na podstawie niskiego prawdopodobieństwa.
Sprawdzanie spójności odpowiedzi pomaga krytycznie oceniać automatyczne porady wellness. Uczy to, by nie traktować wskazówek zdrowotnych generowanych przez aplikacje jako ostatecznej prawdy medycznej.
Wizualizacja sieci i kontrolowanie uprzedzeń
Skorzystaj z darmowych symulatorów online, aby zobaczyć, jak wagi modelu dostosowują się podczas treningu na małych, demonstracyjnych zbiorach danych. Zauważysz, że dla użytkownika końcowego wnioskowanie (inference) trwa zazwyczaj zaledwie od kilku milisekund do kilku sekund.
Kontroluj rekomendacje zdrowotne, testując różne dane demograficzne na wejściu, aby wychwycić potencjalne uprzedzenia (bias) odziedziczone po danych treningowych. Wczesne zauważenie tych błędów zapobiega zniekształconym poradom fitness.
Te proste kroki dają specjalistom wellness namacalne doświadczenie z uczeniem nadzorowanym. Rozpoczęcie tej przygody budzi ekscytację, ale musisz pamiętać o realistycznych ograniczeniach, aby bezpiecznie korzystać z tych rozwiązań.
Typowe błędy i kwestie do rozważenia
Nawet najpotężniejsze systemy komputerowe mają swoje wyraźne granice techniczne. Testy pokazują, że świadomość pułapek pozwala użytkownikom wellness podchodzić do tych narzędzi z realistyczną pewnością siebie, bez ulegania szumowi medialnemu czy lękom.
Zarządzanie własnymi oczekiwaniami zapewnia lepsze rezultaty przy interpretacji codziennych danych zdrowotnych. Dzięki takiemu podejściu technologia pozostaje pomocna, a nie niebezpieczna.
Unikanie pułapki czarnej skrzynki
Użytkownicy czasami zakładają, że wyniki działania algorytmów są całkowicie obiektywne i wolne od uprzedzeń. Jednak modele głębokiego uczenia dziedziczą i mogą wzmacniać błędy systematyczne (biases) obecne w ich oryginalnych danych treningowych.
Ta rzeczywistość wymaga wyraźnego kontrolowania systemów, co potwierdzają niedawne badania nad sprawiedliwością algorytmów w sektorze technologicznym. W aplikacjach zdrowotnych oznacza to konieczność stałego weryfikowania sugestii dietetycznych czy treningowych.
Dobrym krokiem jest korzystanie z wizualizacji takich jak SHAP czy Grad-CAM, które pomagają zinterpretować, na czym model faktycznie się skupia. Usuwa to aurę tajemniczości i pozwala dostrzec potencjalne błędy.
Rozpoznawanie halucynacji i granic kreatywności
Częstym błędem jest oczekiwanie od modelu językowego oryginalnej kreatywności lub idealnej dokładności. Generowane treści jedynie łączą na nowo wzorce z danych treningowych, bez prawdziwej innowacyjności czy intencji poznawczej.
Najnowocześniejsze modele są trenowane na petabajtach danych, a koszty tego procesu sięgają setek milionów dolarów, jak podaje Databricks Blog (2026). Mimo tak ogromnych inwestycji, wciąż zdarzają im się niespójności faktograficzne.
Zawsze weryfikuj obietnice dotyczące fitnessu czy wellness w oparciu o sprawdzone, naukowe źródła. Traktuj algorytm jako partnera do burzy mózgów, a nie lekarza.
Postępy w 2026 roku i odpowiedzialne korzystanie
Choć transformery umożliwiają równoległe przetwarzanie w modelach od 2017 roku, obecne wersje wciąż nie posiadają prawdziwego zrozumienia i mogą halucynować fakty. Niedawne badania nad Gradient-Region Analyzed Spectral SHAP (GRASS) z 2026 roku poprawiają interpretowalność skomplikowanych danych.
Pasjonaci wellness powinni testować systemy przy użyciu różnorodnych danych wejściowych, aby na własne oczy zobaczyć te ograniczenia. Praktyczne testy to najlepszy nauczyciel cyfrowej biegłości.
Traktowanie tych platform jako narzędzi pomocniczych, wspierających profesjonalne porady zdrowotne, przynosi najlepsze rezultaty. Podsumowując, połączenie wiedzy technicznej z krytycznym myśleniem pozwala mądrzej i bez lęku korzystać z technologii wellness.
FAQ
Czy AI to to samo co ludzki mózg lub sieci neuronowe?
Użytkownicy często zakładają, że sztuczna inteligencja naśladuje prawdziwy mózg, jednak testy pokazują, że sieci neuronowe to czysto matematyczne struktury. Wykorzystują one setki warstw (jak podaje IBM), które dopasowują wzorce bez udziału jakiejkolwiek świadomości.
To rozróżnienie zmniejsza lęk u specjalistów wellness korzystających z narzędzi wspierających zdrowie psychiczne. Pokazuje też jasną, praktyczną wartość prognoz dotyczących formy w aplikacjach.
Jak modele takie jak ChatGPT właściwie generują odpowiedzi?
Duże modele językowe wykorzystują tokeny tekstowe przekształcone w osadzenia (embeddings) oraz mechanizmy uwagi z architektury transformerów z 2017 roku. Przewidują one najbardziej prawdopodobne kolejne słowa na podstawie statystyk z ogromnych zbiorów danych treningowych.
Testy pokazują, że pozwala to tworzyć spójne porady wellness, choć brakuje im głębszego zrozumienia. Ponieważ wnioskowanie (inference) trwa milisekundy, możesz śmiało eksperymentować z promptami, aby uzyskać lepsze wskazówki zdrowotne i bezpieczniej korzystać z technologii.
Jaka jest różnica między AI, uczeniem maszynowym a głębokim uczeniem?
Sztuczna inteligencja to ogólny cel informatyki, podczas gdy uczenie maszynowe polega na wykrywaniu konkretnych wzorców w danych w celu tworzenia prognoz bez użycia sztywnego kodu. Głębokie uczenie wykorzystuje wielowarstwowe sieci neuronowe i propagację wsteczną.
Wiele nowoczesnych aplikacji wellness wciąż opiera się na prostszych technikach uczenia maszynowego. Ta wiedza pomaga osobom nietechnicznym śmiało oceniać spersonalizowane rekomendacje.
Jak system AI uczy się bez wyraźnego zaprogramowania?
Uczenie nadzorowane wykorzystuje etykietowane przykłady, podczas gdy uczenie nienadzorowane znajduje ukryte wzorce w danych. Propagacja wsteczna dostosowuje miliony wewnętrznych wag po zmierzeniu błędów prognozy na bilionach tokenów, jak podaje Databricks (2026).
Użytkownicy potwierdzają, że ten proces odczarowuje skomplikowane aplikacje fitness. To właśnie dzięki temu systemy cyfrowe z czasem coraz lepiej dopasowują swoje sugestie wellness do tuoiich potrzeb.
Dlaczego AI czasami popełnia oczywiste błędy lub halucynuje?
Systemy te opierają się na prawdopodobieństwie statystycznym z danych treningowych, a no nie na rzeczywistym zrozumieniu. Dlatego mogą z pełnym przekonaniem podawać błędne informacje lub wzmacniać uprzedzenia obecne w zbiorach treningowych.
Testy pokazują, że wielokrotne zadawanie tego samego pytania często ujawnia te niespójności. Jako użytkownik wellness warto konfrontować te wyniki ze źródłami medycznymi, zamieniając to ograniczenie w nawyk mądrego, codziennego weryfikowania informacji.
Can AI be creative or truly understand what it produces?
Nowoczesne platformy nie mają intencji, oryginalności ani samoświadomości. Generowane wyniki jedynie łączą na nowo wzorce tekstowe z ogromnych zbiorów danych, bez żadnej ukrytej świadomości.
Badania pokazują, że sieci neuronowe skutecznie przybliżają funkcje matematyczne (zgodnie z pracą Cybenko z 1989 roku), ale wciąż pozostają jedynie biernymi narzędziami. To jasne zrozumienie pomaga cieszyć się nowatorskimi pomysłami wellness, zachowując jednocześnie realistyczne oczekiwania i krytyczne myślenie.
Jak działają tokeny, osadzenia (embeddings) i mechanizmy uwagi?
Tekst wejściowy jest dzielony na tokeny przypisywane do wektorów liczbowych, które oddają relacje znaczeniowe. Następnie mechanizm uwagi ocenia wagę poszczególnych elementów w sekwencji, co stało się możliwe dzięki transformerom z 2017 roku.
Dzięki temu nowoczesne chatboty zdrowotne mogą błyskawicznie generować odpowiedzi dopasowane do kontekstu. Użytkownicy wskazują, że wizualne schematy ułatwiają zrozumienie tematu, zmniejszając poczucie przytłoczenia przy codziennym korzystaniu z funkcji wellness opartych na AI.
Czy obecna AI jest wyjaśnialna, czy zawsze będzie czarną skrzynką?
Najnowsze osiągnięcia z 2026 roku, takie jak CW-Net opisywany w Nature oraz GRASS, aktywnie poprawiają techniczną interpretowalność. Pomaga to ludziom lepiej przewidywać zachowanie maszyn w zautomatyzowanych systemach zdrowotnych.
Choć pewien stopień niejasności pozostaje, narzędzia diagnostyczne takie jak Grad-CAM wizualnie wskazują konkretne obszary skupienia uwagi algorytmu. Testy pokazują, że ten stały postęp buduje kluczowe zaufanie u specjalistów wellness korzystających z cyfrowej diagnostyki lub zaawansowanych monitorów aktywności bez pełnej przejrzystości matematycznej.
Udostępnij ten artykuł
Link copied!
Komentarze
(0)
Zostaw komentarz
Twój adres e-mail nie zostanie opublikowany. Wszystkie pola są wymagane.

Komentarze
(0)Zostaw komentarz
Twój adres e-mail nie zostanie opublikowany. Wszystkie pola są wymagane.