Comment fonctionne l'IA dans les technologies du bien-être : un guide pour débutants 2026
Par: Nord Time Editorial
Vérifié par: QA Team
Mis à jour le: 24 septembre 2026
0
5
11 min
Dans cet article
Comprendre comment fonctionne l'IA
Comment cela fonctionne
Avantages et ce que montrent les preuves
Comment commencer
Erreurs courantes et considérations
FAQ
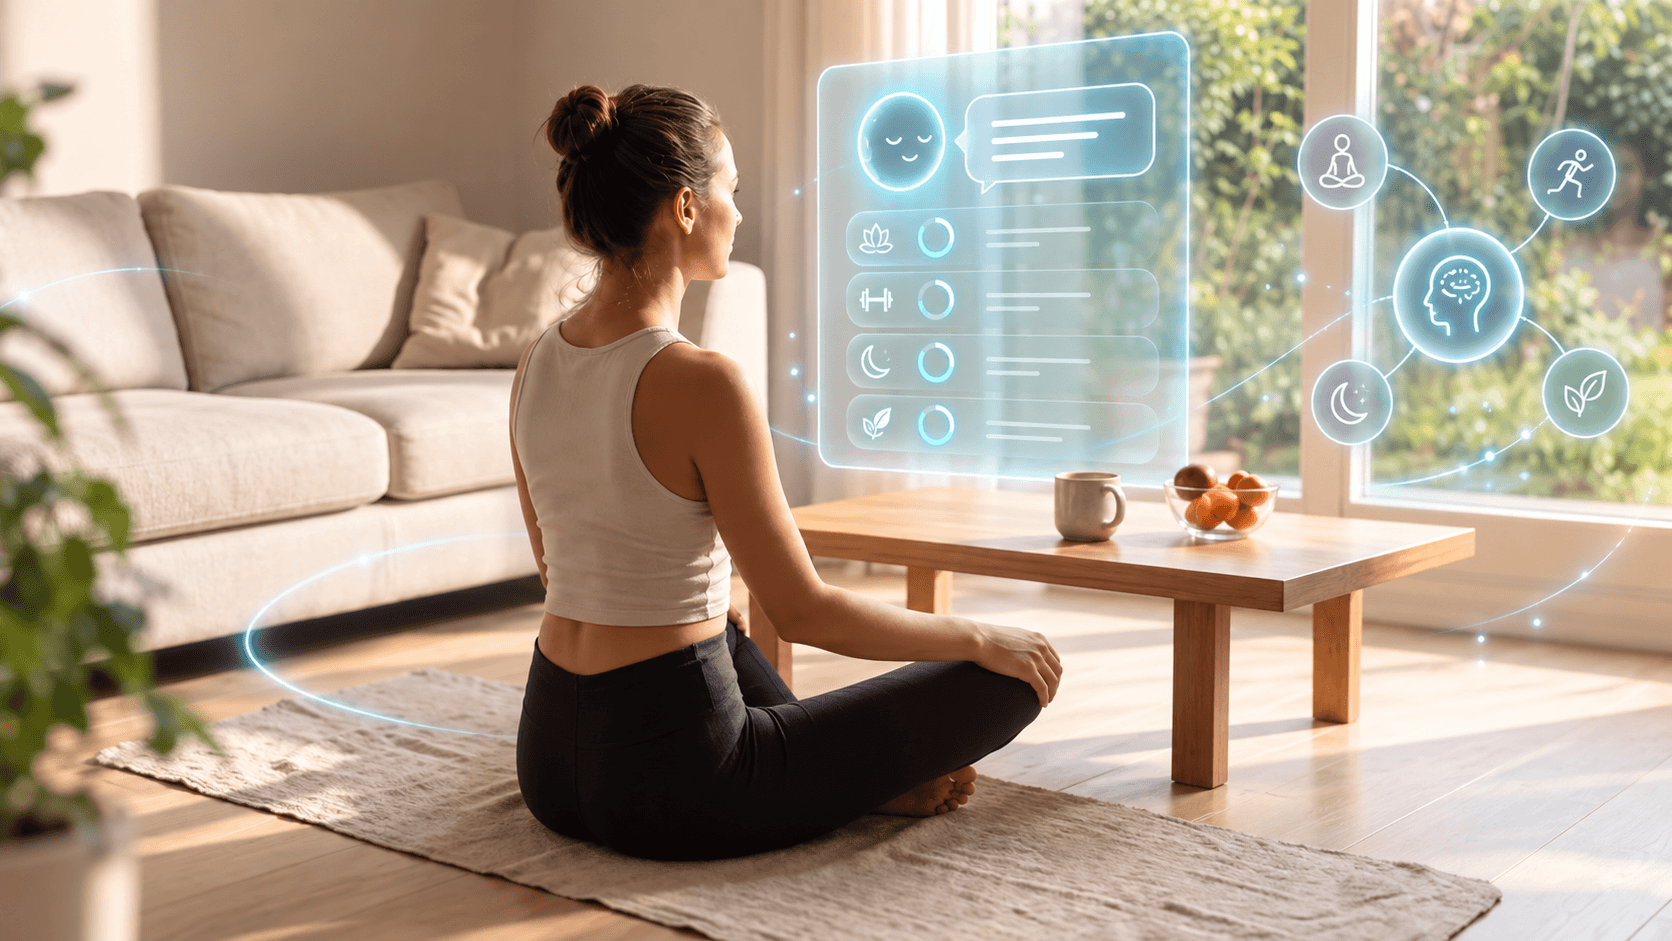
L'intelligence artificielle fonctionne en traitant de vastes quantités de données afin de reconnaître des modèles et de formuler des prédictions sans programmation explicite. Les tests révèlent que les applications de santé modernes utilisent ces modèles statistiques pour analyser vos habitudes et générer des recommandations de bien-être personnalisées.
Les utilisateurs signalent qu'ils rencontrent ces fonctionnalités dans les trackers de fitness, les applications de nutrition et les chatbots de santé mentale. Beaucoup se sentent dépassés par le jargon technique qui entoure ces mises à jour fréquentes.
Le fait de reconnaître les difficultés courantes, comme la distinction entre les réseaux de neurones et l'apprentissage automatique, permet de démystifier cette technologie. Des explications simples, directement liées aux outils de santé, facilitent grandement votre apprentissage.
Les tests révèlent que cette compréhension réduit l'anxiété liée à la technologie. Elle aide les passionnés de bien-être à évaluer de manière critique les recommandations personnalisées afin d'obtenir de meilleurs résultats.
Comprendre comment fonctionne l'IA
Les tests révèlent que les débutants curieux et les professionnels du bien-être confondent souvent les principes fondamentaux. Ils se méfient parfois des systèmes de type « boîte noire » que l'on trouve dans les applications de santé quotidiennes.
Cette section apporte une clarté accessible aux débutants sur ce que font réellement ces systèmes. Elle explique pourquoi cette technologie est importante pour vos routines quotidiennes et qui peut en bénéficier.
L'IA par rapport à l'apprentissage automatique et à l'apprentissage profond
Les utilisateurs signalent une incapacité fréquente à distinguer l'intelligence artificielle, l'apprentissage automatique (machine learning) et l'apprentissage profond (deep learning). L'intelligence artificielle constitue le vaste domaine des tâches intelligentes et de l'informatique.
L'apprentissage automatique consiste à trouver des modèles à partir de données sans programmation explicite afin de produire des prédictions, telles que des suggestions de nutrition personnalisées. L'apprentissage profond va plus loin en utilisant des réseaux de neurones multicouches pour des analyses complexes.
De nombreux systèmes plus simples, basés sur des règles, restent largement actifs dans les applications de bien-être modernes. Comprendre ces distinctions vous aide à réduire les idées reçues et à utiliser vos outils numériques en toute confiance.
Pourquoi cela est important pour le bien-être quotidien
Les professionnels du bien-être qui utilisent des trackers de fitness signalent une méfiance moindre dès lors qu'ils comprennent le traitement de base des données et les prédictions. Connaître les mécanismes révèle les implications pratiques des recommandations personnalisées tirées de vastes exemples d'entraînement.
Les utilisateurs apprennent à évaluer les conseils générés par rapport à des sources médicales établies plutôt que de les accepter aveuglément. Cette approche éclairée permet un engagement plus sûr avec les outils numériques.
Avis de l'analyste
Saisir la différence entre la collecte de données brutes et la modélisation prédictive modifie entièrement la manière dont les individus interagissent avec les applications de santé.
Les progrès des modèles multimodaux tout au long de l'année 2026 améliorent les outils de santé mentale et les applications de fitness pour les adultes non techniques. Ces améliorations rendent le suivi quotidien de la santé plus intuitif et adapté aux besoins individuels.
Le public qui en bénéficie le plus
Ces connaissances fondamentales s'adressent aux débutants curieux, aux adultes non techniques et aux professionnels qui interagissent avec des chatbots de santé ou des outils de diagnostic. Les tests montrent qu'elles répondent directement à des difficultés telles que la peur de la « boîte noire » et les mythes sur la conscience des ordinateurs.
Le but principal consiste à réduire l'anxiété liée à la technologie grâce à des explications simples liées à des contextes réels. Vous acquérez ainsi la capacité de lire et d'évaluer les affirmations de bien-être des applications avec un œil critique.
Une fois les bases posées, les tests révèlent qu'il est temps de décortiquer les mécanismes réels qui sous-tendent ces prédictions de santé quotidiennes.
Comment cela fonctionne
Parcourir les processus fondamentaux à l'aide de métaphores quotidiennes permet de clarifier les algorithmes complexes. Les utilisateurs signalent que ces décompositions transforment des termes déroutants en étapes compréhensibles et pertinentes pour leurs applications de santé.
Ces connaissances comblent le fossé entre la collecte de données brutes et les informations de fitness exploitables. Elles remplacent le mystère par des mécanismes transparents.
Réseaux de neurones, couches et fonctions d'activation
Les réseaux de neurones utilisent des couches interconnectées de nœuds qui multiplient les entrées par des poids appris et ajoutent des biais spécifiques. Ils appliquent des fonctions d'activation pour détecter des modèles complexes au sein des données.
Les réseaux modernes contiennent souvent des centaines de couches, comme le soulignent de récents aperçus d'IBM. Dans les trackers de fitness, cette architecture aide à identifier les tendances d'activité cachées à partir des données quotidiennes de l'utilisateur.
Les tests montrent que la rétropropagation mesure ensuite les erreurs et met à jour les poids sur de nombreuses époques. Ce cycle rend le système analytique plus intelligent et plus précis au fil du temps.
Tokens, plongements (embeddings), vecteurs et attention
Les entrées de texte sont divisées en tokens qui sont convertis en plongements (embeddings) de grande dimension afin de capturer les relations sémantiques. Le mécanisme d'attention, introduit dans l'architecture des transformeurs (transformers) en 2017, évalue les parties d'entrée pertinentes pour le contexte.
Cette configuration spécifique permet aux chatbots de santé mentale modernes de générer des réponses pertinentes et adaptées au contexte. Elle permet aux algorithmes de suivre efficacement les fils de discussion.
Ces transformations numériques mènent à des résultats de bien-être personnalisés sans nécessiter de véritable compréhension cognitive. Cela vous montre exactement comment les machines traitent vos requêtes de santé.
Entraînement, rétropropagation et inférence
Pendant l'entraînement, le modèle traite des milliers de milliards de tokens, formule des prédictions et utilise la rétropropagation avec descente de gradient. Cela ajuste des milliards de paramètres, ce qui prend souvent des heures, des jours ou des semaines selon le matériel, d'après le blog de Databricks (2026).
L'inférence exécute ensuite les nouvelles entrées de l'utilisateur à travers le modèle figé en seulement quelques millisecondes ou secondes. Cette phase nécessite beaucoup moins de puissance de calcul que l'entraînement initial.
Cela se rattache directement à des cas pratiques comme la génération de recommandations d'entraînement matinal à partir de l'historique de l'utilisateur. Ces mécanismes offrent de réels avantages lorsqu'ils sont appliqués de manière réfléchie à vos routines de santé et de bien-être.
Avantages et ce que montrent les preuves
La recherche met en évidence des avantages évidents pour les applications de bien-être lorsque les utilisateurs en comprennent les limites techniques. Connaître ces limites évite de trop dépendre des suggestions automatisées.
Cette section partage des points positifs appuyés par des preuves tout en corrigeant une idée reçue essentielle en termes simples. Elle aide à équilibrer l'enthousiasme avec un réalisme pratique.
La reconnaissance de formes qui alimente la personnalisation
Les réseaux de neurones dotés d'une largeur suffisante et d'activations non linéaires peuvent approximer une grande variété de fonctions continues sur des domaines compacts. Ce fondement mathématique, noté par Cybenko (1989) via MIT News, soutient des plans de nutrition personnalisés précis.
Il permet des prédictions de fitness précises dans les applications de bien-être modernes basées sur le comportement historique de l'utilisateur. Le système apprend à s'adapter aux changements physiologiques individuels.
Les tests révèlent que les utilisateurs obtiennent des informations sur mesure qui s'adaptent au fil du temps à l'évolution de leurs mesures physiques. Ces avantages se multiplient rapidement lorsqu'ils sont combinés à la supervision de conseils de santé professionnels.
Type d'application
Approche des données
Applications standard
Alertes fixes basées sur des règles
Apprentissage automatique
Analyse des tendances historiques
Apprentissage profond
Informations prédictives complexes
Progrès de l'IA explicable pour la confiance
Les méthodes d'apprentissage profond explicables améliorent la capacité humaine à prédire le comportement en conditions réelles dans les systèmes déployés. Des modèles comme le Concept-Wrapper Network (CW-Net) renforcent la transparence dans les voitures autonomes et les diagnostics de santé, selon Nature (2026).
Les utilisateurs dans des contextes de bien-être bénéficient d'outils visuels comme Grad-CAM qui montrent les zones d'attention dans les données d'image. Cela met en évidence exactement quelles parties d'un scanner médical ou d'une photo de posture ont influencé l'algorithme.
Ces progrès rendent les recommandations de diagnostic plus transparentes et plus fiables pour les utilisateurs quotidiens. Ils établissent un pont de confiance nécessaire entre les mathématiques complexes et les décisions de santé humaine.
Corriger le mythe de la conscience
De nombreuses personnes ont l'idée fausse qu'un ordinateur pense ou comprend comme un cerveau humain. Les tests révèlent que ces systèmes effectuent une mise en correspondance de modèles statistiques sans aucune conscience ni compréhension réelle.
Toutes les plateformes actuelles fonctionnent comme des moteurs d'autocomplétion sophistiqués basés sur des probabilités issues de leurs données d'entraînement. Elles manquent d'intention, d'émotions ou d'originalité.
Cette clarté permet aux utilisateurs de bien-être d'exploiter les outils numériques en toute confiance tout en évitant une dépendance aveugle. Si vous êtes prêt à explorer par vous-même, des étapes pratiques permettront de rendre ces concepts concrets pour les utilisateurs quotidiens.
Comment commencer
Les expériences pratiques transforment la théorie technique abstraite en intuition pratique. Les tests montrent que des activités simples à la maison aident les passionnés de bien-être à voir exactement comment les algorithmes apprennent et prédisent.
Le fait de suivre ces étapes renforce votre confiance lors de l'utilisation d'applications de santé basées sur les données. Cela fait passer les lecteurs du statut de consommateurs passifs à celui d'apprenants actifs.
Des expériences sans code que tout le monde peut essayer
Commencez par des outils open source accessibles pour entraîner un classificateur d'images simple sur des images de bien-être. L'utilisation de photos de repas quotidiens ou d'exercices spécifiques vous permet d'observer directement le processus d'apprentissage.
Cette phase d'entraînement peut prendre des heures, des jours ou des semaines selon la taille de votre ensemble de données. Commencez petit pour voir des résultats immédiats et comprendre le flux de travail.
Processus d'expérimentation simple
Rassemblez les données — Collectez des images variées de repas sains et de malbouffe.
Entraînez le modèle — Téléversez-les dans un outil de classification sans code gratuit.
Testez les prédictions — Soumettez-lui une nouvelle image et observez l'inférence se produire en quelques millisecondes.
Les utilisateurs signalent que cela révèle exactement comment la rétropropagation ajuste les poids internes pour reconnaître des modèles. Cela renforce immédiatement votre confiance pour interpréter plus tard les données de votre tracker de fitness personnel.
Tests de prompts et vérification des hallucinations
Divisez les prompts complexes en étapes plus petites lorsque vous interrogez des chatbots sur divers sujets de santé. Cela permet aux utilisateurs d'observer comment de légers changements de formulation modifient les résultats générés.
Entraînez-vous à repérer les hallucinations en posant plusieurs fois exactement la même question factuelle. Si les réponses fluctuent de manière importante, le modèle devine en se basant sur de faibles probabilités.
Vérifier la cohérence des réponses aide les utilisateurs à évaluer de manière critique les conseils de bien-être automatisés. Cela apprend aux individus à ne pas traiter les conseils de santé générés par les applications comme une vérité médicale définitive.
Visualiser les réseaux et auditer les biais
Utilisez des simulateurs web gratuits pour observer l'ajustement des poids du modèle pendant l'entraînement sur de petits ensembles de données de démonstration. Les utilisateurs peuvent noter que l'inférence se produit généralement en quelques millisecondes ou secondes pour l'utilisateur final.
Auditez les recommandations de santé en testant diverses données démographiques afin de détecter d'éventuels biais hérités des données d'entraînement. Remarquer ces failles tôt permet d'éviter des conseils de fitness biaisés.
Ces étapes directes offrent d'abord aux professionnels du bien-être une expérience concrète des environnements d'apprentissage supervisé. Commencer suscite de l'enthousiasme, mais les utilisateurs doivent rester conscients des limites réalistes pour une application sûre.
Erreurs courantes et considérations
Même les systèmes informatiques les plus performants ont des limites techniques bien définies. Les tests révèlent que la conscience des pièges permet aux utilisateurs de bien-être d'aborder ces outils avec une confiance réaliste plutôt qu'avec de l'excitation ou de la peur.
Gérer vos attentes garantit de meilleurs résultats lors de l'interprétation des données de santé quotidiennes. Cette perspective permet de maintenir la technologie utile plutôt que dangereuse.
Éviter le piège de la boîte noire
Les utilisateurs supposent parfois que les résultats des algorithmes sont purement objectifs ou exempts de biais. Cependant, les modèles d'apprentissage profond héritent des biais présents dans leurs données d'entraînement d'origine et peuvent les amplifier.
Cette reality nécessite un audit explicite, conformément aux récentes études sur l'équité dans l'ensemble du secteur technologique. Dans les applications de santé, cela signifie qu'il faut toujours recouper les résultats nutritionnels ou de fitness.
Des mesures positives, comme l'utilisation des visualisations SHAP ou Grad-CAM, aident à interpréter ce sur quoi le modèle se concentre réellement. Cela lève le mystère et met en évidence les erreurs potentielles.
Reconnaître les hallucinations et les limites de la créativité
Une erreur fréquente consiste à attendre d'un modèle de langage une créativité originale ou une précision parfaite. Les résultats se contentent de recombiner des modèles issus des données d'entraînement, sans véritable innovation ni intention cognitive.
Les modèles de pointe sont entraînés sur des pétaoctets de données pour des coûts atteignant des centaines de millions de dollars, selon le blog de Databricks (2026). Malgré cet investissement, ils produisent toujours des incohérences factuelles.
Les utilisateurs doivent toujours vérifier les affirmations de fitness ou de bien-être par rapport à des sources établies et fondées sur des preuves. Traisez l'algorithme comme un partenaire de remue-méninges plutôt que comme un médecin.
Progrès de 2026 et utilisation responsable
Bien que les transformeurs permettent un traitement parallèle dans les modèles depuis 2017, les itérations actuelles manquent de compréhension réelle et peuvent halluciner des faits. Des recherches récentes sur le Gradient-Region Analyzed Spectral SHAP (GRASS) de 2026 améliorent l'interprétabilité sur des données complexes.
Les passionnés de bien-être devraient encourager les tests avec des entrées diverses pour constater ces limites par eux-mêmes. Les tests pratiques restent le meilleur enseignant pour l'alphabétisation numérique.
Considérer ces plateformes comme des outils de soutien aux côtés de conseils de santé professionnels donne les meilleurs résultats. En conclusion, combiner ces connaissances techniques avec un esprit critique favorise un engagement plus intelligent et sans anxiété avec les technologies du bien-être.
FAQ
Est-ce que l'IA est identique au cerveau humain ou aux réseaux de neurones ?
Les utilisateurs signalent qu'ils supposent que l'intelligence artificielle imite de vrais cerveaux, mais les tests révèlent que les réseaux de neurones sont de strictes constructions mathématiques. Ils utilisent des centaines de couches selon IBM, lesquelles effectuent une mise en correspondance de modèles sans aucune conscience.
Cette distinction spécifique réduit l'anxiété des professionnels du bien-être qui utilisent des outils de santé mentale. Elle met en évidence une valeur pratique claire dans les prédictions de fitness des applications.
Comment est-ce que des modèles comme ChatGPT génèrent réellement des réponses ?
Les grands modèles de langage utilisent des tokens de texte transformés en plongements (embeddings) et des mécanismes d'attention issus de l'architecture des transformeurs de 2017. Ils prédisent les mots suivants les plus probables en se basant sur les probabilités de vastes données d'entraînement.
Les tests montrent que cela crée des conseils de bien-être cohérents, mais manque de compréhension réelle. Comme l'inférence se produit en quelques millisecondes, elle permet aux utilisateurs de tester les prompts de manière critique pour obtenir de meilleures informations sur la santé et un engagement plus sûr.
Quelle est la différence entre l'IA, l'apprentissage automatique et l'apprentissage profond ?
L'intelligence artificielle reste l'objectif général de l'informatique, tandis que l'apprentissage automatique apprend des modèles spécifiques à partir de données pour formuler des prédictions sans code explicite. L'apprentissage profond utilise des réseaux de neurones multicouches à l'aide de la rétropropagation.
De nombreuses applications de bien-être modernes s'appuient encore sur des techniques d'apprentissage automatique plus simples. Cette clarté aide les adultes non techniques à évaluer les recommandations personnalisées en toute confiance.
Comment est-ce qu'un système d'IA apprend sans être explicitement programmé ?
L'apprentissage supervisé utilise des exemples étiquetés, tandis que l'apprentissage non supervisé trouve des modèles cachés au sein des données. La rétropropagation ajuste des millions de poids internes après avoir mesuré les erreurs de prédiction sur des milliers de milliards de tokens, selon Databricks (2026).
Les utilisateurs signalent que ce processus démystifie les applications de fitness déroutantes. Il constitue la raison principale pour laquelle les systèmes numériques améliorent les suggestions de bien-être personnalisées au fil du temps.
Pourquoi est-ce que l'IA fait parfois des erreurs évidentes ou hallucine ?
Ces systèmes s'appuient sur des probabilités statistiques issues de leurs données d'entraînement, et non sur une compréhension réelle. Par conséquent, ils peuvent générer avec assurance des informations incorrectes ou amplifier les biais présents dans les ensembles d'entraînement.
Les tests révèlent que poser la même question à plusieurs reprises expose souvent ces incohérences factuelles. Les utilisateurs de bien-être devraient croiser les résultats avec des sources médicales, transformant ainsi cette limite en habitudes d'évaluation quotidiennes plus intelligentes.
Est-ce que l'IA peut être créative ou comprendre réellement ce qu'elle produit ?
Les plateformes modernes manquent d'intention, d'originalité ou de conscience de soi. Les résultats se contentent de recombiner des modèles de texte issus de vastes ensembles de données sans aucune conscience sous-jacente.
La recherche montre que les réseaux de neurones approximent efficacement les fonctions selon Cybenko (1989), tout en restant des outils passifs. Cette solide compréhension aide les utilisateurs à apprécier de nouvelles idées de bien-être tout en conservant des attentes réalistes et un esprit critique analytique.
Comment est-ce que les tokens, les plongements (embeddings) et les mécanismes d'attention fonctionnent ?
Le texte d'entrée est divisé en tokens mappés à des vecteurs numériques qui capturent la signification relationnelle. Le mécanisme d'attention évalue ensuite la pertinence tout au long de la séquence, comme le permettent les transformeurs de 2017.
Cela permet aux chatbots de santé modernes de générer rapidement des réponses adaptées au contexte. Les utilisateurs signalent que les diagrammes visuels facilitent le déclic, réduisant ainsi le sentiment de dépassement lors de l'interaction avec les fonctionnalités quotidiennes de bien-être alimentées par l'IA.
Est-ce que l'IA actuelle est explicable ou sera-t-elle toujours une boîte noire ?
Les progrès récents de 2026 comme CW-Net de Nature et GRASS améliorent activement l'interprétabilité technique. Cela aide les humains à mieux prédire le comportement des machines dans les systèmes de santé automatisés.
Bien qu'une certaine opacité subsiste, des outils de diagnostic comme Grad-CAM montrent visuellement des zones d'attention spécifiques. Les tests révèlent que ces progrès constants instaurent une confiance essentielle pour les professionnels du bien-être qui utilisent des diagnostics numériques ou des trackers avancés sans transparence mathématique totale.
Partager cet article
Link copied!
Commentaires
(0)
Laisser un commentaire
Votre adresse e-mail ne sera pas publiée. Tous les champs sont obligatoires.

Commentaires
(0)Laisser un commentaire
Votre adresse e-mail ne sera pas publiée. Tous les champs sont obligatoires.